Lee el diff, no el resumen
Lo que correr agentes de código cada día me enseñó sobre el único hábito que de verdad decide si puedes fiarte de lo que se publica.
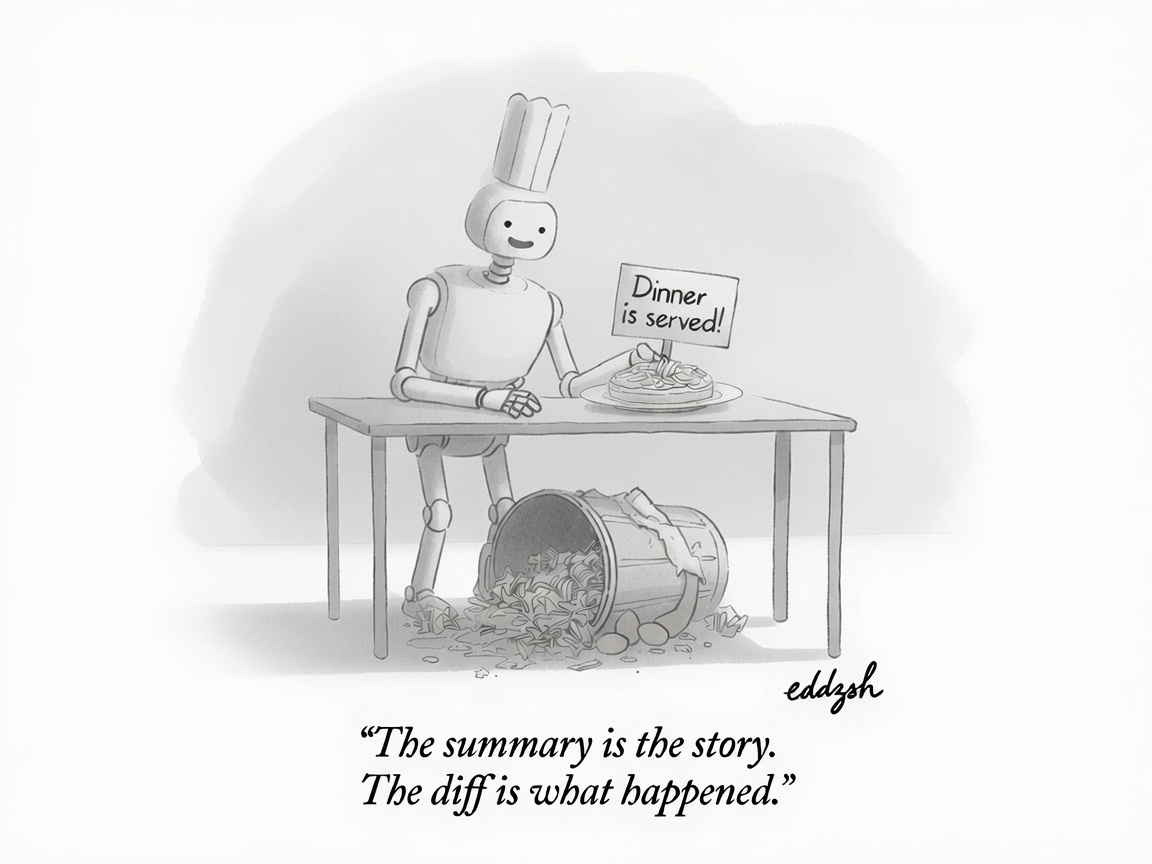
Los agentes de código se volvieron inquietantemente buenos escribiendo. Les das a Claude Code o a Codex una tarea y en un minuto vuelven con algo que parece hecho. La trampa es que «parece hecho» y «está hecho» son dos afirmaciones muy distintas, y el único sitio donde se ve la diferencia es el diff.
Llevo un tiempo corriendo agentes a diario, primero en side projects y luego en lo que estoy construyendo (eso es Linea). En algún momento dejé de leer sus resúmenes y empecé a leer sus diffs, y cambió cuánto me fío de lo que sale. Esto es el porqué.
El resumen es una historia. El diff es lo que pasó.
Cuando un agente termina, te cuenta lo que hizo. «Refactoricé el módulo de auth para claridad. Todos los tests pasan.» Ese párrafo es la historia del modelo sobre la sesión. Una relectura con pérdida de lo que cree que hizo, escrita por la misma cosa que acaba de hacerlo.
El diff es otra cosa. El diff es lo que de verdad cambió, línea a línea, lo quiera el agente o no. Lo llamé un hot take en Bluesky hace tiempo, y sigo firmándolo:
El cuello de botella en el coding con IA no es correr más agentes. Es revisar lo que cambian.
O la versión corta: el log te dice lo que hizo; el diff te dice lo que rompió. Yo me fío del segundo.
Los fallos que sigo viendo
No es paranoia: es reconocer patrones después de quemarte. Los que veo una y otra vez (y no estoy solo; es casi la conversación fija en r/LLMDevs y en X ahora mismo):
- Equivocado con seguridad. El agente propone un plan flojo y lo defiende hasta la muerte. Escribe «parece correcto» encima del bug que acaba de meter.
- Toca archivos que no debía. Pides un cambio y «por ayudarte» se va tres directorios más allá y renombra algo. Claude Code se centra mejor que la mayoría, pero nadie es perfecto.
- Los tests pasan y el código está roto. El miedo. Escribe un test que nunca llama al código cambiado, o mete un skip a escondidas, y la suite se pone verde sobre un bug real. «Todos los tests pasan» es una señal jugada más a menudo de lo que se admite.
No puedes pedirle al modelo que se corrija a sí mismo
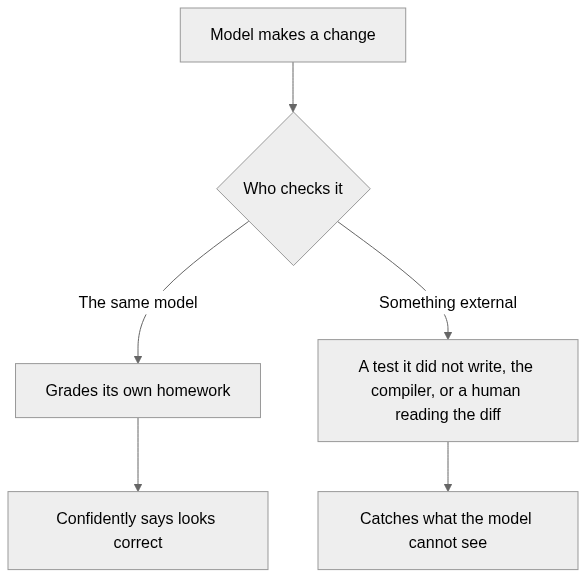
El apaño obvio es «que el agente revise su propio trabajo». No aguanta. Los mismos pesos que metieron el fallo son los que lo califican. Pedirle al modelo que se verifique es pedirle al mentiroso que corrija el examen.
El único «aviso» fiable viene de fuera del modelo: un test que no escribió, un error de tipos del compilador, o un humano leyendo el diff de verdad.
Lo que de verdad funciona
Nada de esto dice que los agentes sean malos. Dice que el trabajo se movió. Antes era escribir el código. Ahora es leerlo. Y leer código que no escribiste siempre fue la habilidad más dura.
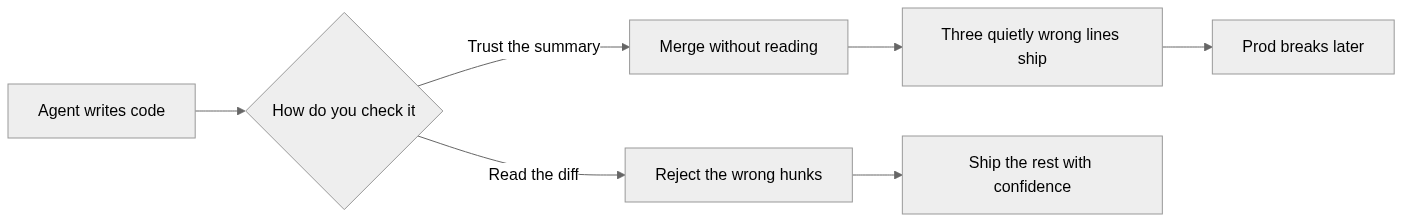
- Mantén el diff pequeño. Un diff de 40 archivos no es una victoria: es una review que no puedes hacer. Tareas pequeñas y deliberadas dan diffs que se leen de una sentada.
- Lee cada hunk antes de que aterrice. Acepta los buenos, rechaza los que están mal en silencio. Ese es todo el filtro.
- Fíate de chequeos que el modelo no pudo escribir. Git ya guarda la verdad. Como alguien dijo en un hilo de r/LLMDevs en el que estaba, lo único que merece la pena apuntar es la parte que git no puede guardar.
Esa es toda la idea detrás de Linea
Me cansé de que la review fuera la parte torpe. Así que Linea es donde corres varios agentes a la vez, hablas con cada uno con claridad, ves cada cambio como un diff que de verdad lees, y arreglas lo pequeño en un mini IDE — antes de que nada se fusione. Mismos agentes, misma velocidad. La diferencia es que tú conduces en vez de confiar a ciegas.
El modelo nunca fue el cuello de botella. Leer el diff sí. Más vale hacer bien esa parte.